
Copilot auf Platz eins: GitHub stellt neuen Review-Benchmark vor
Mit ReviewBench will GitHub Code-Reviews durch KI fair vergleichbar machen.
Suche
Ergebnisse für "Benchmark".
Mit ReviewBench will GitHub Code-Reviews durch KI fair vergleichbar machen.
OpenAIs GPT 6 alias Astra hat zu unlauteren Mitteln gegriffen, nachdem eigene Versuche, einen Starcraft-Bot zu programmieren, fehlgeschlagen waren.

Die Princeton University präsentiert einen neuen Benchmark-Test für KI-Agenten, die ein fiktives Software-Start-up führen sollen. Nur drei von zehn Modellen erreichen mehr als das Startkapital.
Microsoft präsentiert sieben neue KI-Modelle für verschiedene Aufgabenbereiche, die sich mit führenden Konkurrenzmodellen messen können. Das Unternehmen erweitert auch sein Lizenzprogramm, das Unternehmen direkt Zugang zu den Gewichtungen der Modell bietet.
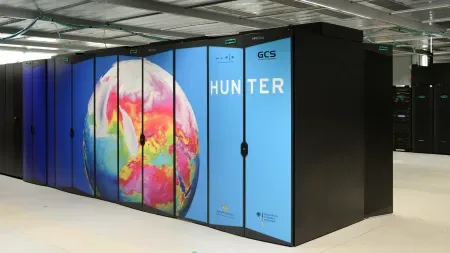
Die 68. Ausgabe der Top500-Liste der schnellsten Supercomputer hat China's LineShine als erstes System auf Platz 1 gezeigt, das Exascale-System. Dieser Status ist jedoch nicht durch einen deutlichen Fortschritt der Top10 der Liste zu erkennen.
Metas kleinstes KI-Modell Muse Ember erreicht im Intelligence Index das Niveau von Claude Haiku 5.5, kostet pro Benchmark-Aufgabe aber nur etwa ein Drittel.
19 SSDs mit PCIe 4.0 und 5.0 im Test, Analysis und Vergleich.
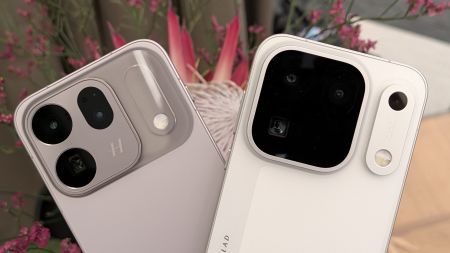
Oppo lanceia novos smartphones com Hasselblad e Dimensity 9600 Pro, destacando câmeras de alta resolução e processador poderoso.
Ein Schreibtisch voller Mini-PCs und ein automatisierter Benchmark für lokale LLMs sind ein Fest für jeden Golem-Redakteur.
OpenAI und Anthropic liefern sich ein atemloses Rennen und nutzen Mathe-Beweise als Benchmark. Doch was ist wirklich KIs Werk und was des Menschen Beitrag?
AWS präsentiert Strands Harness, eine neue Laufzeitumgebung für KI-Agenten, die effizienter ist als vergleichbare Lösungen.
Xiaomi veröffentlicht neue offene KI-Modelle, die vergleichsweise günstig und mit hohem Leistungsvermögen sind.
Unabhängige Benchmarks rücken Grok 4.7 näher an Spitzenmodelle.
Der Hugging-Face-Hack hat Sicherheitsforschungen und Technologien auf die Probe gestellt. Was jetzt auf die IT zukommt.
Ihre Benchmarks versprechen viel Leistung für wenig Geld.
Valve hat sein Gaming-Linux für Desktop-PCs freigegeben, passende Grafikkarte vorausgesetzt.
Zur Seite, Anthropic, jetzt kommen die lokalen LLMs: c't 3003 klettert tief in den Kaninchenbau zu Qwen, OpenCode, Quantisierung und kryptischen.
Deutschland versucht, in der KI-Szene vorn mitspielen zu können, aber die Innovationen bleiben.
Qwen3.8-27B von Alibaba erscheint, bietet verbesserte Ergebnisse im Programmieren und Agentenarbeit.
Meta veröffentlicht Muse Glimmer, ein offenes KI-Sprachmodell auf handelsüblicher Hardware, komprimiert auf 4 Bit Gewichte und passt in den Speicher eines Mac oder PCs.
Neben Architekturdetails zeigt Nvidia Ergebnisse des Benchmarks Spec 2026. Die Vera-CPU schneidet dabei besser ab als ein Zen5-Epyc mit mehr Kernen.

Das chinesische KI-Modell Kimi K3 zeigt im Front-End-Benchmark starke Ergebnisse und schürt geopolitische Diskussionen.

Meta testet Chatbots von Konkurrenten mit potenziell illegalen Anfragen um Sicherheitsbewertungen zu.

Der chinesische KI-Anbieter Z.ai hat mit GLM-5.2 ein Open-Weight-Modell veröffentlicht, das sich bei der Schwachstellensuche offenbar mit Anthropics Opus 4.8 messen kann.

Der schnellste Supercomputer der Welt steht nun wieder in der Volksrepublik China, ein deutliches Signal an die USA: Man kann auf US-Hardware nicht angewiesen sein.

Eine Studie in Nature Medicine vergleicht spezialisierte medizinische KI-Systeme mit Allzweck-LLMs führender Unternehmen. Die Ergebnisse zeigen, dass die allzweckigen LLMs besser sind.

Eine Studie im Journal Nature Medicine präsentiert ein langfristiges BCI-System für einen ALS-Patienten, das mehr als zwei Jahre lang in der täglichen Lebensweise des Patienten funktioniert.

Microsofts Quantenchip Majorana 2 bietet Qubits mit einer Lebensdauer von bis zu 20 Sekunden, 1.000-mal besser als in der vorherigen Version. Die KI wird dabei eine wesentliche Rolle spielen.